Web Summit Lisboa 2026
CTO da ClickHouse mostra como a IA transforma sites e fotos em números
Alexey Milovidov rodou 22 modelos abertos sobre 150 milhões de exemplos e demonstrou usos de embeddings em busca e classificação de dados

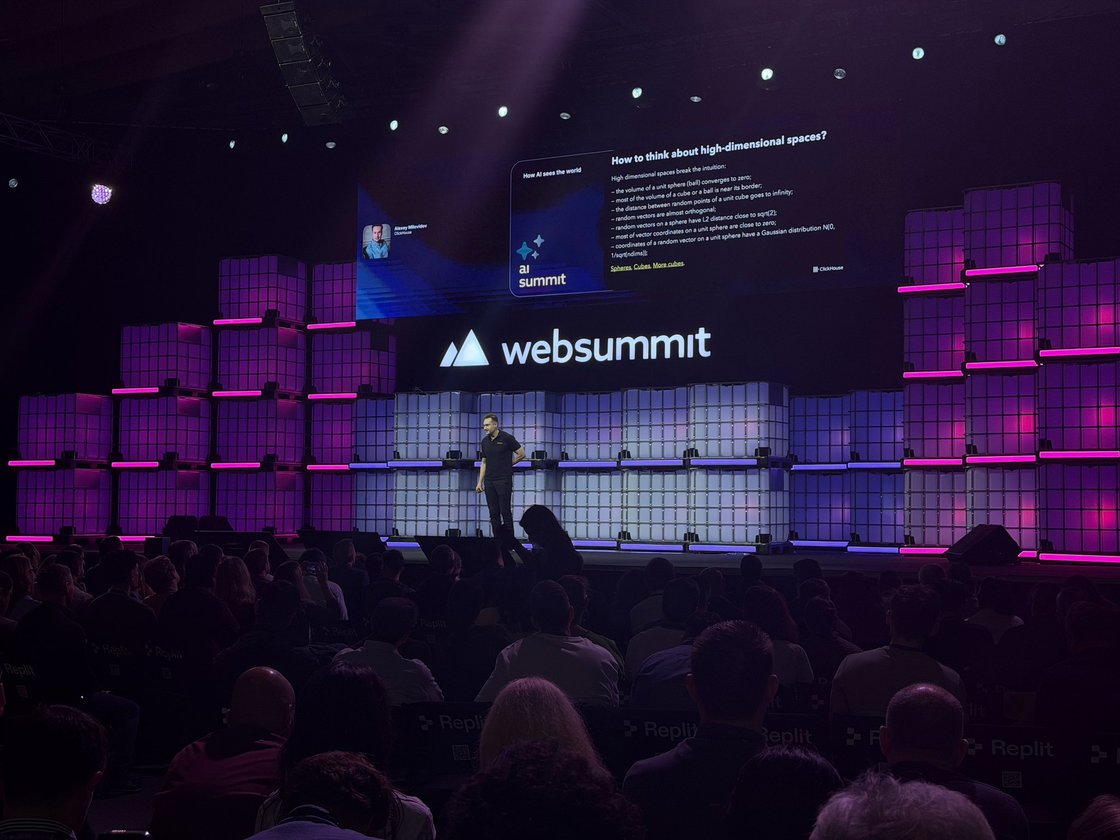
Alexey Milovidov, cofundador e CTO da ClickHouse, mostrou no Web Summit Lisboa, nesta terça-feira (10), como modelos de IA transformam textos, imagens e sites em vetores numéricos, os embeddings, e como esses vetores servem para busca e classificação de dados.
Segundo a descrição da sessão “How AI sees the world”, ele rodou 22 modelos abertos sobre 150 milhões de exemplos reais para ver o que esses números revelam.
Embeddings: como a IA transforma conteúdo em números
Milovidov disse que há várias definições de embedding e que o tipo que interessa a ele é o de um modelo treinado para uma tarefa específica, como medir a similaridade entre textos e imagens ou recuperar a resposta mais relevante para uma pergunta.
Ele também descreveu uma versão sem modelo de linguagem, o embedding esparso. O texto é dividido em palavras, cada palavra passa por um hash e o vetor registra quantas vezes cada hash aparece. Segundo ele, a consulta SQL que faz isso tem poucas linhas.
Galáxias de dados e os conjuntos da demonstração
Na demonstração, Milovidov exibiu um site em que conjuntos de dados aparecem como galáxias navegáveis, com zoom e modo 3D. Um dos conjuntos reunia fotos de gatos agrupadas em aglomerados, outro trazia comentários do Hacker News e um terceiro, chamado por ele de “a internet”, mostrava capturas de tela de sites.
Ele disse ter usado 100 milhões de fotos e 40 milhões de comentários. Para os sites, criou a própria coleção, de 18 milhões de páginas, que baixou com 1.000 funções AWS Lambda ao longo de uma a duas semanas.
“Eu quero metadados de cada site da internet para entender como a internet funciona”, disse. Os dados ficaram em uma tabela com uma coluna do tipo JSON, com atributos de HTML, CSS, cookies, scripts e imagens.
Modelos de embeddings e custo de processamento
Milovidov afirmou que há centenas de modelos de embeddings e que escolheu muitos deles, incluindo modelos de pesos abertos de até 8 bilhões de parâmetros. Segundo ele, é possível calcular os vetores em GPUs de uma instância g6.12xlarge da AWS, com custo de algumas centenas de dólares, ou por APIs de modelos e pelo OpenRouter.
Para quem quer trabalhar com dados e aprendizado de máquina, o MBA USP/Esalq em Data Science, Inteligência Artificial e Analytics aborda Machine Learning, Big Data e Business Intelligence, segundo a descrição do curso.
As inscrições são feitas em https://mbauspesalq.com/cursos/mba-em-data-science-e-analytics
Busca e classificação com embeddings
“O que os embeddings podem fazer por você? É a pergunta errada. Pergunte a si mesmo o que você pode fazer pelos embeddings”, disse Milovidov. Ele citou busca, classificação e o mapeamento de um espaço em outro como usos.
Em um exemplo, treinou uma regressão logística pequena para análise de sentimento e a aplicou a comentários do Hacker News sobre o Google, a partir de um índice pré-calculado. Segundo ele, o processamento chega a centenas de milhões de registros por segundo.
Em outro exemplo de classificação, ele aplicou o método a textos sobre Elon Musk, que foram agrupados em temas como sociedade e política.
Similaridade entre vetores
Os vetores podem ser comparados por distâncias, como a euclidiana, chamada de L2, e a do cosseno. Segundo Milovidov, com vetores normalizados a escolha da distância pouco altera o resultado.
Ele disse que, em espaços com muitas dimensões, vetores aleatórios tendem a ser ortogonais, ou seja, têm pouco em comum entre si.
O Web Summit Lisboa segue até quinta-feira (12), na MEO Arena e nos pavilhões da FIL. Acompanhe a cobertura no portal Central do Varejo e em nossas redes sociais!
Imagens e informações: Amanda Dechen, Especialista em Comunicação Estratégica no MBA USP/Esalq
Leia também: